
一种多智能体动态协同方法及系统
本技术属于多智能体协同,具体涉及一种多智能体动态协同方法及系统。
背景技术:
1、在密码设计、密码分析、科研辅助和数据处理等复杂任务场景中,单一大语言模型智能体难以同时稳定完成规划、检索、生成、验证与工具调用等多个环节,因此在计算机系统中部署多个智能体协同工作已成为常见实现方式。大语言模型已能够承担生成、推理、代码编写和工具调用等任务,在复杂场景中,一个任务往往需要经过规划、检索、生成、检查与修正等多个环节,由多个智能体分工协作完成。这类任务的共同特点是:目标和约束在执行过程中逐步明确,中间结果可能相互冲突,外部工具或人工反馈会不断改变后续处理方向。在计算机系统层面,多智能体协作直接受两类资源约束:其一是模型上下文窗口与token成本,重复注入完整历史会使推理开销随协作轮次线性甚至超线性增长;其二是调用次数与时延,无效调用和重复调用会显著拉长任务完成时间并占用算力。仅增加智能体数量不能改善上述指标,反而会加剧信息冲突、成本上升和失败归因困难。因此,如何有效组织多个智能体围绕同一任务状态协同工作,并把每轮执行结果转化为后续调度决策的依据,成为多智能体系统在计算机实现层面亟需解决的关键问题。
2、现有技术方案可概括为四类:
3、第一类是对话式或固定流程式多智能体框架,例如autogen(wu q, bansal g,zhang j, et al. autogen: enabling next-gen llm applications via multi-agentconversation. arxiv preprint arxiv:2308.08155, 2023)、camel(li g, hammoud h ak, itani h, et al. camel: communicative agents for "mind" exploration oflarge language model society. advances in neural information processingsystems 36, 2023. arxiv:2303.17760)、metagpt(hong s, zhuge m, chen j, et al.metagpt: meta programming for a multi-agent collaborative framework.international conference on learning representations, 2024. arxiv:2308.00352)和chatdev(qian c, liu w, liu h, et al. chatdev: communicative agents forsoftware development. proceedings of the 62nd annual meeting of theassociation for computational linguistics, 2024. arxiv:2307.07924)。这类方案通过预设角色分工和会话协议组织多个智能体交互,其协作状态以自然语言消息序列的形式存在于对话历史中,调度依赖预设流程或由模型在自然语言层面临时决定。
4、第二类是共享记忆或黑板式系统。经典黑板架构(hayes-roth b. a blackboardarchitecture for control. artificial intelligence, 1985, 26(3): 251-321)以公共数据区加控制单元组织多个知识源;近期工作已将黑板架构引入大模型多智能体系统,例如han等人(han b, zhang s. exploring advanced llm multi-agent systems basedon blackboard architecture. arxiv preprint arxiv:2507.01701, 2025)和salemi等人(salemi a, parmar m, goyal p, et al. llm-based multi-agent blackboardsystem for information discovery in data science. arxiv preprint arxiv:2510.01285, 2025)的方案。
5、第三类是上下文路由、任务图与编排系统,例如rcr-router(liu j, kong z,yang c, et al. rcr-router: efficient role-aware context routing for multi-agent llm systems with structured memory. arxiv preprint arxiv:2508.04903,2025)、dyntaskmas(yu j, ding y, sato h. dyntaskmas: a dynamic task graph-driven framework for asynchronous and parallel llm-based multi-agent systems.arxiv preprint arxiv:2503.07675, 2025)和adaptorch(yu g. adaptorch: task-adaptive multi-agent orchestration in the era of llm performance convergence.arxiv preprint arxiv:2602.16873, 2026)。这类方案解决的是“给智能体看什么上下文”或“按什么拓扑执行”的问题。
6、第四类是自反思迭代方法与结构化工具调用实践,例如reflexion(shinn n,cassano f, gopinath a, et al. reflexion: language agents with verbalreinforcement learning. advances in neural information processing systems 36,2023. arxiv:2303.11366)与self-refine(madaan a, tandon n, gupta p, et al.self-refine: iterative refinement with self-feedback. advances in neuralinformation processing systems 36, 2023. arxiv:2303.17651)将执行反馈或自我评价以文本形式加入后续提示驱动迭代改进;业界通行的函数调用/工具调用机制以jsonschema约束单次工具调用的输入输出格式。
7、然而,上述现有技术方案在连续执行复杂任务时存在以下缺陷。第一,缺少统一的结构化任务状态。任务目标、约束、中间结论和执行反馈以自然语言散落在对话历史缓冲区、工具调用日志和非结构化记忆中,程序无法直接读取任务进展,也无法据此决定下一步调度;为弥补信息缺失,系统被迫重复注入完整历史,导致token消耗与推理时延随协作轮次增长。第二,路由决策缺少完整动作约束。现有系统的调度输出至多包含“选哪个智能体”和“给什么上下文”,没有把一次调用规定为包含子任务、输出结构、验证条件和回退条件的数据对象,导致输出格式不受控、下游解析失败率高、错误无法定位到具体调用、失败后系统状态不可恢复。第三,反馈没有形成闭环。执行失败、验证不通过或人工反馈至多触发重试或改写提示文本,不会程序化地更新任务状态条目、智能体能力评估和路由策略参数,使同类失败被重复触发,无效调用与冗余成本持续累积。第四,冲突与置信状态不可裁决。共享信息不携带置信度、证据与验证状态,系统无法区分候选结论与已验证事实,冲突只能交由模型在自然语言层面临时化解,处理结果不可复现、不可审计。
8、因此,如何在计算机系统中建立一种多智能体协同机制,使任务状态以结构化数据统一维护,使每次智能体调用成为具有明确输入、输出、验证与回退规则的可执行数据对象,并使执行反馈能够程序化地更新任务状态、智能体能力评估与后续路由策略,从而在提升任务完成率的同时降低上下文冗余带来的token消耗与无效调用开销,是当前亟需解决的技术问题。
技术实现思路
1、为了解决现有技术中存在的上述问题,本技术提供了一种多智能体动态协同方法及系统。本技术要解决的技术问题通过以下技术方案实现:
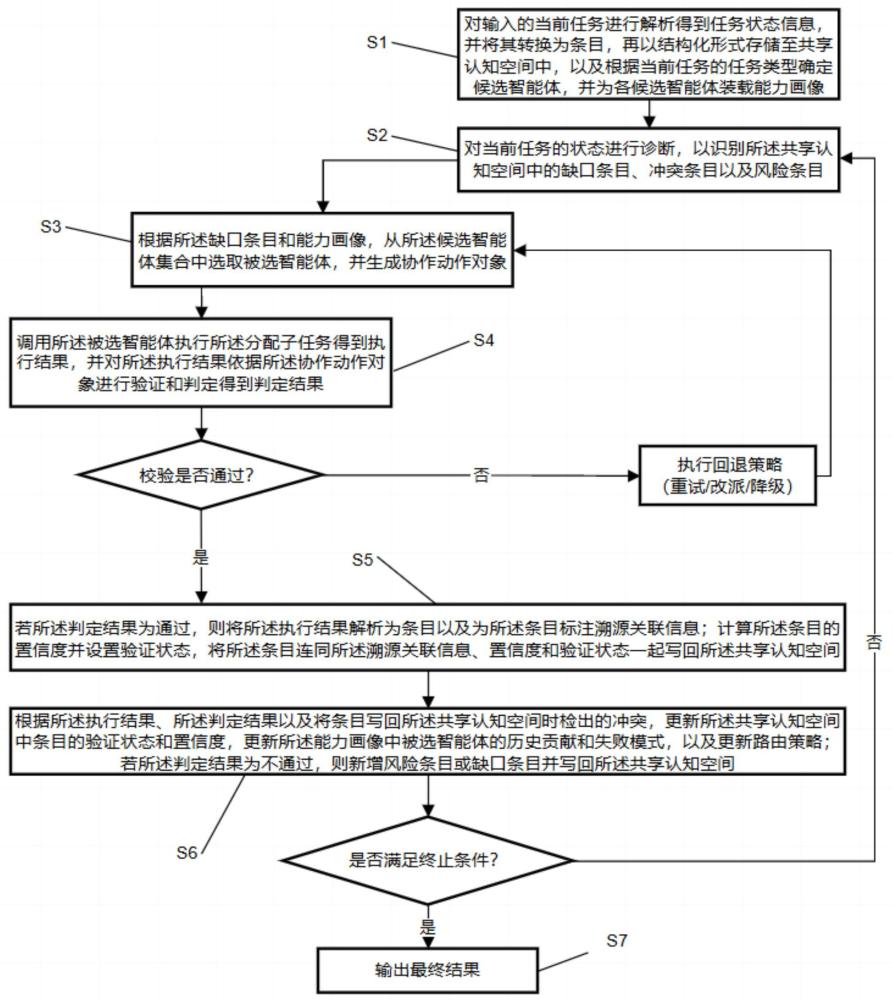
2、一种多智能体动态协同方法包括:
3、s1,对输入的当前任务进行解析得到任务状态信息,并将其转换为条目,再以结构化形式存储至共享认知空间中,以及根据当前任务的任务类型确定候选智能体,并为各候选智能体装载能力画像;
4、s2,对当前任务的状态进行诊断,以识别所述共享认知空间中的缺口条目、冲突条目以及风险条目;
5、s3,根据所述缺口条目和所述能力画像,从所述候选智能体集合中选取被选智能体,并生成协作动作对象;所述协作动作对象至少包括所述被选智能体、分配子任务、上下文切片、期望输出结构、验证条件和回退条件;
6、s4,调用所述被选智能体执行所述分配子任务得到执行结果,并对所述执行结果依据所述协作动作对象进行验证和判定得到判定结果;
7、s5,若所述判定结果为通过,则将所述执行结果解析为条目以及为所述条目标注溯源关联信息;计算所述条目的置信度并设置验证状态,将所述条目连同所述溯源关联信息、置信度和验证状态一起写回所述共享认知空间;若所述判定结果为不通过,则新增风险条目或缺口条目并写回所述共享认知空间;
8、s6,根据所述执行结果、所述判定结果以及将条目写回所述共享认知空间时检出的冲突,更新所述共享认知空间中条目的验证状态和置信度,更新所述能力画像中所述被选智能体的历史贡献和失败模式,以及更新路由策略;
9、s7,判断是否满足终止条件,若满足则输出最终结果,否则返回s2。
10、有益效果:
11、1、本技术通过共享认知空间以带元数据的结构化条目集中保存任务目标、任务阶段、信息缺口、风险冲突和执行反馈等信息,使后续智能体基于同一结构化状态工作,减少了上下文不一致导致的错误传播。同时,配合预算受限的上下文切片机制,每轮调用仅向智能体注入完成当前子任务所需的最小充分上下文,而非完整任务历史,直接降低了token消耗与推理时延。
12、2、本技术通过协作动作对象同时规定被选智能体、分配子任务、上下文切片、期望输出结构、验证条件和回退条件六个要素,使每次智能体调用成为具有明确输入、输出、验证与回退规则的可执行数据对象。输出可依据期望结构进行程序化校验、失败可依据回退条件自动恢复、责任可追踪到具体调用,有效降低了输出格式不受控、下游解析失败率高、错误无法定位以及失败后系统状态不可恢复等问题。
13、3、本技术通过反馈耦合机制在每轮执行后同步更新共享认知空间中的条目状态、智能体能力画像以及路由策略,使系统能够自动重路由、回退、转移阶段或终止,避免同类失败被重复触发,无效调用与冗余成本持续累积,从而提升了任务完成率与失败恢复率。
14、4、本技术通过为共享认知空间中的每个条目设置置信度、证据引用、依赖关系和验证状态等元数据,使系统能够程序化地区分未经验证的中间结论、已被证据支持的事实、存在冲突的候选结论与已通过验证的最终产物。冲突判定通过相似度阈值加领域规则的方式进行程序化裁决,而非交由模型在自然语言层面临时化解,使处理结果可复现、可审计。
15、5、本技术的核心闭环“共享认知空间—协作动作对象—反馈耦合更新”不依赖特定领域词表或固定角色,可迁移到密码设计、密码分析、科研辅助、数据处理、企业流程协同和多工具自动化等多种连续协作任务场景。不同应用场景仅需替换条目类型词表、智能体角色与验证器实现,核心机制保持不变。
16、以下将结合附图及实施例对本技术做进一步详细说明。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com