
个性化数字会议智能体的制作方法
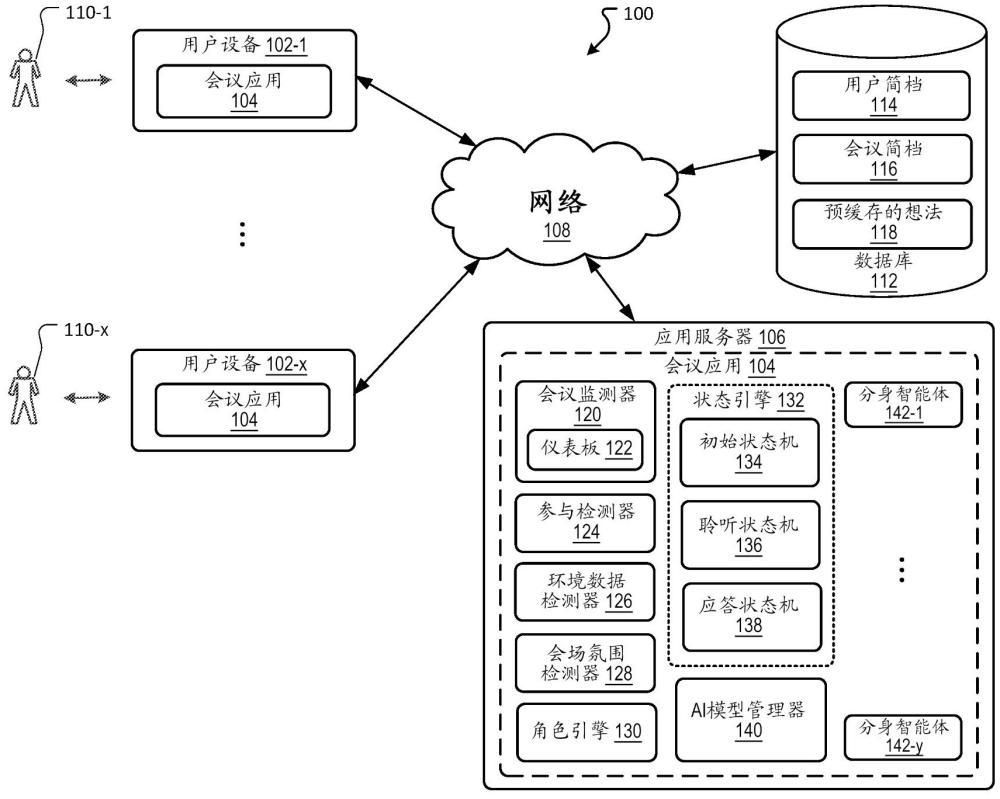
背景技术:
1、工作的日益显著的特点是团队高度多样化且全球分布,团队成员分散在不同的物理地点和时区。相应地,业务会议越来越多地通过视频和/或音频会议虚拟进行。随着此类虚拟通信的广泛使用,日程安排冲突更容易发生,例如,这归因于更加灵活的混合工作安排、全球时区差异以及团队成员因预约、休假等而不在办公室的常见挑战。因此,人们常常无法参加其受邀参加或有兴趣参加的所有会议。
2、关于这些和其他一般考虑因素,已经描述了实施例。此外,尽管已经讨论了相对具体的问题,但是应当理解,实施例不应限于解决背景技术中标识的具体问题。
技术实现思路
1、为了解决上述会议冲突方面的挑战,本申请的各方面涉及一种个人数字智能体(或“分身(ditto)”),该个人数字智能体被预训练为用户(例如,人类)的数字代理。通过采用该人类的角色(例如,个性、举止、偏好、知识,以及在一些情况下,该人类的逼真视觉外形和声音),个人数字智能体能够有效地代表该人类进行交互。例如,数字智能体可以与会议同事进行对话,并具有与未出席的人类相似的声音、面部表情和肢体姿态。此外,经预训练的数字智能体可以聆听团队所说的内容、提出澄清问题、代表该人类回答问题,并提出该人类希望团队考虑的观点。由于数字智能体在视觉上类似于该人类、听起来像该人类并且像该人类一样行动,因此数字智能体看起来与其他远程参会者非常相似,从而改善其他出席者的会议体验,并在人类团队成员缺席的情况下提高会议效率。
2、提供本 技术实现要素: 是为了以简化形式介绍将在下面的具体实施方式中进一步描述的一些概念。本发明内容不旨在标识所要求保护的主题的关键特征或必要特征,也不旨在用于限制所要求保护的主题的范围。
1. 一种系统,包括:
2.根据权利要求1所述的系统,其中所述角色与所述用户的逼真表示、所述用户的奇幻表示或其间表示范围内的任何表示相关联。
3.根据权利要求1所述的系统,其中所述监测连续进行、以规则的时间间隔进行或在动态窗口上进行。
4.根据权利要求1所述的系统,其中所确定的所述第一动作的所述第一渲染是音频渲染、视觉渲染或视听渲染。
5.根据权利要求1所述的系统,所述一组操作还包括:
6.根据权利要求5所述的系统,其中所述第一基础模型与所述第二基础模型相同或所述第一基础模型与所述第二基础模型不同。
7.根据权利要求1所述的系统,其中所确定的所述第一动作的所述第一渲染至少部分地基于所述角色。
8.根据权利要求1所述的系统,其中确定所述第一动作包括以下之一:询问所述用户、查询相同或不同的基础模型或选择预缓存的想法。
9. 根据权利要求1所述的系统,所述一组操作还包括:
10.一种使用一个或多个基础模型来实例化数字智能体的方法,包括:
11.根据权利要求10所述的方法,还包括:
12.根据权利要求11所述的方法,其中所述状态机在所述思考循环的每次迭代之后返回到所述监测。
13. 根据权利要求10所述的方法,还包括:
14.一种使用一个或多个基础模型来实例化数字智能体的方法,包括:
15. 根据权利要求14所述的方法,还包括:
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com