
一种针对大尺度场景的稀有类点云语义分割模型构建方法
本发明涉及点云语义分割,尤其涉及一种针对大尺度场景的稀有类点云语义分割模型构建方法。
背景技术:
1、近年来,随着激光雷达(lidar)、航空摄影测量、无人机测绘以及城市级三维重建技术的快速发展,获取大范围、高密度、高精度三维点云数据的能力显著增强,为大尺度城市空间的精细化语义理解提供了丰富的数据支撑。点云语义分割技术通过对三维点云中的每一个点赋予语义类别标签,广泛应用于智慧城市建设、高精地图生产、城市规划管理、灾害评估、交通基础设施监测以及三维数字孪生等领域。传统基于人工几何特征的分割方法在复杂城市场景下面临显著挑战,而深度学习的引入为该领域带来了新的突破,但现有技术仍存在亟待解决的瓶颈问题。
2、比如早期基于人工特征的点云分割方法通常依赖高度差、法向量、曲率、粗糙度、局部密度等几何描述符,并结合随机森林、支持向量机(support vector machine,svm)等分类器完成逐点类别判别。这类方法在规则场景或小范围点云中具有一定可解释性,但其特征表达能力受人工设计规则限制,在城市级点云中面对建筑、植被、水体、桥梁、车辆、船舶等多类目标共存且空间尺度差异显著的情况时,容易出现类别边界模糊、稀有类别漏分以及复杂结构误分等问题。以pointnet、pointnet++为代表的深度学习方法通过端到端方式学习点云特征,显著提升了点云语义分割的自动化程度;但pointnet对局部几何结构建模不足,pointnet++虽然引入分层采样和邻域聚合机制,但在大规模点云场景中仍受限于邻域搜索开销和局部感受野范围,难以充分捕获远距离空间依赖关系。
3、随后,基于卷积、稀疏卷积和transformer的点云网络逐渐成为三维场景理解的重要技术路线。稀疏卷积网络通过体素化方式将无序点云转换为规则稀疏张量,在室内外点云分割任务中取得了较好效果,但体素分辨率的选择往往面临精度与计算量之间的权衡:体素过大会损失细粒度几何边界,体素过小则显著增加显存占用与计算开销。pointtransformer等基于注意力机制的方法能够增强局部邻域内点与点之间的特征交互,但传统自注意力机制计算复杂度较高,在百万级乃至千万级城市点云上难以直接扩展。pointtransformer v3(ptv3)通过空间填充曲线将无序点云序列化,并在序列化后的patch内部执行注意力计算,有效降低了大规模点云处理的复杂度,为城市级点云语义分割提供了新的可行方案。
4、然而,直接采用现有ptv3框架处理大尺度城市点云仍存在不足。首先,城市点云数据天然具有显著的类别不均衡特征,大面积地物如建筑、地形、植被通常占据大量点数,而水体、桥梁、车辆、船舶等类别在空间分布上更加稀疏,且往往只出现在局部区域,这就导致不同语义类别的点数分布通常存在显著差异。传统训练过程通常采用均匀随机采样或固定裁剪策略,包含稀有类别的局部区域被选入训练样本的概率较低,这使得模型在训练过程中更频繁地接触主导类别,而对稀有类别的学习不充分,即使模型整体精度较高,稀有类别仍可能出现召回率不足、类别边界不稳定和误分类严重等问题。现有类别重加权损失、静态过采样或欠采样方法虽能一定程度缓解类别不均衡,但其权重或采样规则通常在训练前固定,难以根据模型在训练过程中的类别学习状态进行动态调整,容易出现对某些类别补偿不足或对已收敛类别过度强化的问题。
5、名词解释:
6、航空摄影测量:利用航空平台搭载相机获取地面影像,并通过多视影像匹配、空中三角测量和三维重建等技术恢复地物三维结构的方法。其优势是覆盖范围广、影像分辨率高,可生成密集点云、数字表面模型和正射影像等成果。
7、三维点云:由大量离散三维点组成的数据集合,每个点通常包含空间坐标信息(x、y、z),并可附带颜色、强度、法向量、类别标签等属性。三维点云能够直接表达物体和场景的几何结构,是三维场景理解的重要数据形式。
8、点云语义分割:对点云中的每一个点进行类别预测的任务,即为每个点赋予语义标签,例如建筑、植被、水体、桥梁、车辆、船舶等。该任务能够实现三维场景的精细化理解,是智慧城市、高精地图和数字孪生等应用中的关键技术。
9、体素化:将连续三维空间划分为规则的立方体网格,并将点云映射到对应网格单元中的过程。体素化可以将无序点云转换为规则或稀疏张量,但体素大小会影响分割精度与计算成本。
10、point transformer v3(ptv3):一种高效点云transformer骨干网络,通过点云序列化、patch分组注意力和空间填充曲线等机制降低大规模点云处理复杂度,适用于大尺度点云语义分割任务。
11、空间填充曲线:一种将多维空间中的点映射为一维序列的曲线或编码方式,尽量保持空间相邻点在序列中也相邻。常见空间填充曲线包括z-order曲线和hilbert曲线。
12、z-order:一种基于坐标二进制交错编码的空间填充曲线,也称morton编码。z-order计算简单、效率高,可将三维点按空间位置转换为一维序列,但局部连续性相对hilbert曲线较弱。
13、hilbert-order:一种具有较强局部保持能力的空间填充曲线,能够更好地保持多维空间中相邻点在一维序列中的邻近关系。相比z-order,hilbert-order通常具有更好的空间连续性,但编码计算更复杂。
14、序列化阶次:指采用不同空间填充曲线或不同遍历方向对点云进行排序得到的序列形式。例如z-order、z-trans、hilbert-order和hilbert-trans可视为不同序列化阶次。
15、patch:在点云序列化后,将连续若干个点划分成的小分组。patch内部进行注意力计算能够在降低计算复杂度的同时保留局部上下文信息。
16、patch注意力:在每个patch内部执行的自注意力计算方式。相比全局注意力,patch注意力只在局部分组内建模点间关系,计算效率更高,但也可能带来patch之间信息交互不足的问题。
17、特征融合:将不同来源、不同尺度或不同分支的特征进行组合的过程。特征融合可用于整合局部几何信息、全局上下文信息以及多序列化阶次信息。
技术实现思路
1、本发明的目的就在于提供一种解决传统大尺度点云语义分割方法中类别长尾分布严重、稀有类别训练曝光不足、单一序列化阶次下patch间空间信息交互不充分以及复杂类别边界区域语义混淆等问题的,一种针对大尺度场景的稀有类点云语义分割模型构建方法。
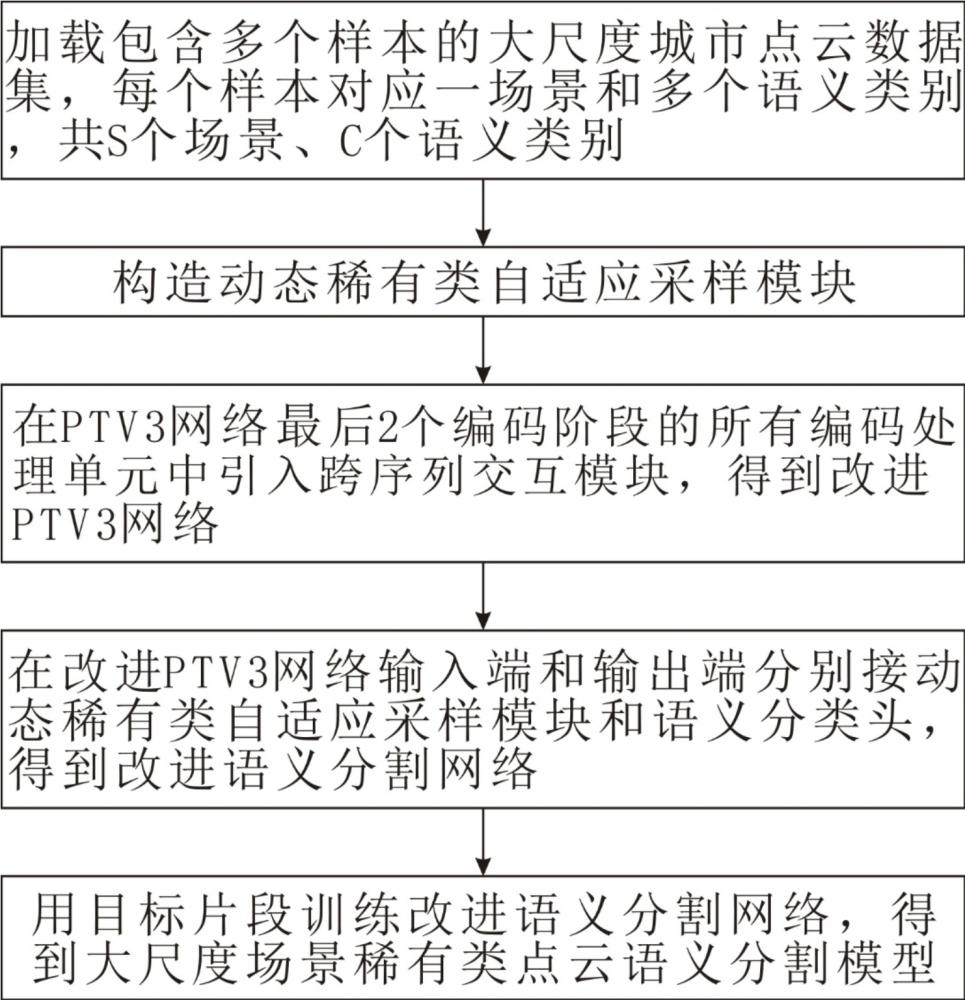
2、为了实现上述目的,本发明采用的技术方案是这样的:一种针对大尺度场景的稀有类点云语义分割模型构建方法,包括以下步骤:
3、s1,加载包含多个样本的大尺度城市点云数据集,每个样本对应一场景和多个语义类别,共s个场景、c个语义类别;
4、s2,构造动态稀有类自适应采样模块,用于基于类别损失自动从场景中选择目标类别,并利用类别中心引导裁剪,生成目标片段x;
5、s3,构造改进ptv3网络,包括s31~s32;
6、s31,获取一ptv3网络,包括点云序列化层、基于u-net结构的编码器和解码器;
7、所述点云序列化层用于对目标片段x生成四组序列化排序索引及其逆排序映射,并对四组序列化排序索引所在的槽位进行随机排列;
8、编码器包括5个编码阶段,各编码阶段包含多个堆叠的编码处理单元,每个编码处理单元对应一序列化排序索引,且最后两层依次为残差连接层和前馈网络;
9、s32,对第4、5个编码阶段中每个编码处理单元,在残差连接层和前馈网络间增设一跨序列交互模块,得到改进ptv3网络,所述跨序列交互模块用于对输入其中的特征进行跨序列交互;
10、s4,改进ptv3网络输入端和输出端分别接动态稀有类自适应采样模块和分类头,得到改进语义分割网络,所述分类头用于输出目标片段中各点的预测语义类别;
11、s5,用目标片段训练改进语义分割网络至收敛,得到大尺度场景稀有类点云语义分割模型。
12、作为优选,所述大尺度城市点云数据集为urbanbis数据集。
13、作为优选,s2中,动态稀有类自适应采样模块,包括类别损失统计层、类别损失估计层、动态采样因子计算层、类别采样概率层、场景采样概率层、选择层、类别中心引导裁剪层;
14、所述类别损失统计层用于统计每次迭代时一批次样本各语义类别的平均交叉熵损失,将第t次迭代中语义类别c标为tc,则tc的平均交叉熵损失为lc(t),1≤c≤c,1≤t≤t,t为训练迭代总次数;
15、所述类别损失估计层用于对lc(t)进行指数平滑得到tc的损失估计值ec(t);
16、所述动态采样因子计算层用于根据ec(t)生成tc的动态采样因子dc(t);
17、所述类别采样概率层用于根据dc(t)生成tc的类别采样概率pc(t);
18、所述场景采样概率层用于根据dc(t)和每次迭代时场景s中各语义类别的点数,生成场景s的场景采样概率,其中第t次迭代场景s的场景采样概率为ps(t);
19、所述选择层用于基于pc(t)和ps(t)选择场景和目标类别;
20、所述类别中心引导裁剪层用于从目标类别中构建候选中心池,并从候选中心池中随机选取目标类别点进行球形裁剪,并对每次剪裁得到的候选点云片段进行质量评分,将评分最高的候选点云片段作为目标片段x。
21、作为优选,类别损失估计层的ec(t)、动态采样因子计算层的dc(t)分别根据下式计算:
22、
23、
24、式中,μ=0.9为指数移动平均动量,ec(t-1)为第t-1次迭代中语义类别c的损失估计值,且当t=1时,ec(0)=1,为第t次迭代中样本包含的语义类别c的点总数;
25、clip[∙,∙,∙]为clip函数,将第t次迭代中语义类别j标为tj,ej(t)为tj的损失估计值ej(t),α为损失难度影响系数,dmin、dmax分别为动态采样因子的下限和上限;
26、作为优选,类别采样概率层生成pc(t)的方法包括sa1~sa2;
27、sa1,计算初始采样概率:
28、
29、式中,exp(∙)为exp函数,为温度参数,dj(t)为tj的动态采样因子;
30、sa2,计算类别采样概率pc(t),,λc为类别采样混合系数。
31、作为优选,所述场景采样概率层在第t次迭代生成ps(t)方法为:
32、sb1,根据下式计算场景s的即时难度评分;
33、
34、式中,cs为场景s包含的语义类别集合,ns,c为场景s内属于语义类别c的点总数,γ为场景类别点数权重指数;
35、sb2,对进行指数移动平均更新,得到场景s的历史场景难度评分;
36、sb3,对rs(t)进行温度缩放和指数归一化,再与经场景采样混合系数λs混合为场景s的场景采样概率ps(t)。
37、作为优选,所述选择层选择方法为:
38、sc1,预设候选类别点数阈值n1,按各场景的场景采样概率随机选择一目标场景sr,统计其中各语义类别的点数;
39、sc2,将点数不小于n1的语义类别标为候选类别,若均小于点n1,则将sr中所有语义类别标为候选类别;
40、sc3,提取各候选类别的类别采样概率,在候选类别范围内重新归一化,得到各候选类别对应的归一化类别采样概率;
41、sc4,按归一化类别采样概率在目标场景sr中随机选择一语义类别作为目标类别。
42、作为优选,所述类别中心引导裁剪层一次剪裁包括sd1~sd3:
43、sd1,预设点云片段包含点的上限nmax、候选中心池上限kpool,从样本中获取目标类别对应的点,若未超过kpool则全部存入候选中心池,否则随机选取kpool个点存入候选中心池,将池中点标为候选中心点;
44、sd2,任选一候选中心点作为一级剪裁中心,按各点与一级裁剪中心间的空间距离由近至远选取邻近点构成一级点云片段;
45、sd3,若一级点云片段p(1)内点数未超过nmax,则其作为候选点云片段,否则任选p(1)中保留的一候选中心点,作为二级裁剪中心选取不超过nmax个点作为候选点云片段;
46、多次剪裁得到多个候选点云片段,其中第r个候选点云片段pr的质量评分为qr;
47、
48、式中,kr为pr中保留的候选中心点数量,nr为pr的点数,min(∙,∙)为取最小值。
49、作为优选,s32中,所述跨序列交互模块包括跨序索引选择层、预处理层、特征摘要层、跨序交叉注意力层、上下文广播与门控增强层、融合输出层;
50、所述跨序索引选择层用于根据编码处理单元的序列化排序索引ocur生成互补序列化槽位索引ocross;
51、所述预处理层用于输入获取残差连接层的输出特征fsa执行点级层归一化,再分别按ocur、ocross重排为当前预处理序列fcur和互补预处理序列fcross;
52、所述特征摘要层用于将fcur、fcross划分为m个点云块,再对点云块内的点特征取均值作为该点云块的特征摘要,并分别将fcur、fcross的m个特征摘要构成摘要序列scur、scross;
53、所述跨序交叉注意力层用于对scur和scross进行层归一化再执行交叉注意力,得到包含m个跨序特征的跨序注意力序列fattn,fattn中第m个跨序特征标记hm,对应fcur的中第m个点云块的点;
54、所述上下文广播与门控增强层用于将fcur内每个点与对应的hm拼接后经门控网络生成门控权重并计算增强特征,fcur第m个点云块中第j个点的门控权重为gm,j,增强特征为δfm,j,,⊙为逐元素乘法;再按ocur的逆排序映射将所有增强特征恢复至fsa中点的顺序,得到点级跨序增强特征矩阵δf;
55、所述融合输出层用于根据下式输出融合特征fout,fout=fsa+droppath(dropout(δf)),式中,dropout为dropout函数,droppath为正则化操作。
56、作为优选,互补序列化槽位索引,mod为取模运算。
57、与现有技术相比,本发明的优点在于:
58、(1)本发明提出的在线自适应稀有类采样机制能够缓解城市点云类别长尾分布问题。与传统点云语义分割训练通常采用均匀随机采样或固定裁剪策略、权重或采样规则通常在训练前固定,无法根据模型训练过程中的类别学习状态动态调整不同,本发明在动态稀有类自适应采样模块中通过统计训练过程中的类别损失变化,并采用指数滑动平均方式更新类别难度估计,再结合动态采样因子和均匀混合概率约束采样分布,使模型能够在不同训练阶段自适应关注尚未充分学习的类别,从而提高稀有类别的学习机会和分割稳定性。
59、(2)本发明提出的稀有类中心引导裁剪机制能够提高有效训练样本质量。与大尺度城市点云中稀有类别因分布稀疏而不容易被忽略不同,本发明在采样阶段根据目标类别选取对应点作为候选中心,引导球形裁剪或局部采样围绕目标类别区域展开,使生成的训练样本更容易包含稀有类别及其周边空间上下文。该机制不仅提升了稀有类别的出现频率,而且保留了稀有类别与邻近类别之间的空间关系,有利于模型学习桥梁与水体、船舶与水域、车辆与道路等复杂语义关联。
60、(3)本发明提出的跨序列交互模块能够弥补传统ptv3多序列化阶次之间缺乏显式交互的问题。与传统ptv3中不同序列化阶次通常独立建模,缺少跨阶次patch级信息交互,导致不同空间遍历方式下捕获的互补几何结构未被充分利用不同,本发明提出跨序列交互模块,在编码阶段,对预处理序列fcur和互补预处理序列fcross,进行点云块(patch)级的摘要和交叉注意力计算,得到跨序注意力序列fattn,再通过门控机制将fattn中第跨序特征回写至逐点特征。该方法能够利用不同空间填充曲线形成的差异化点云块组织关系,增强跨点云块空间上下文建模能力,改善复杂边界区域和细小目标区域的语义表达。
61、综上,本发明以ptv3为基础框架,通过自适应采样策略动态改善训练样本的类别分布,并通过跨序列交互模块实现不同空间填充曲线下点云块之间的信息互补,可以在提高稀有类别学习充分性的同时,增强模型对复杂空间结构和类别边界的表达能力,从而提升大尺度城市点云语义分割的整体精度与鲁棒性,为复杂城市场景点云的高精度语义分割提供更加有效的技术方案。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com