
一种生成式问答回答证据链构建、溯源校验与风险识别方法与流程
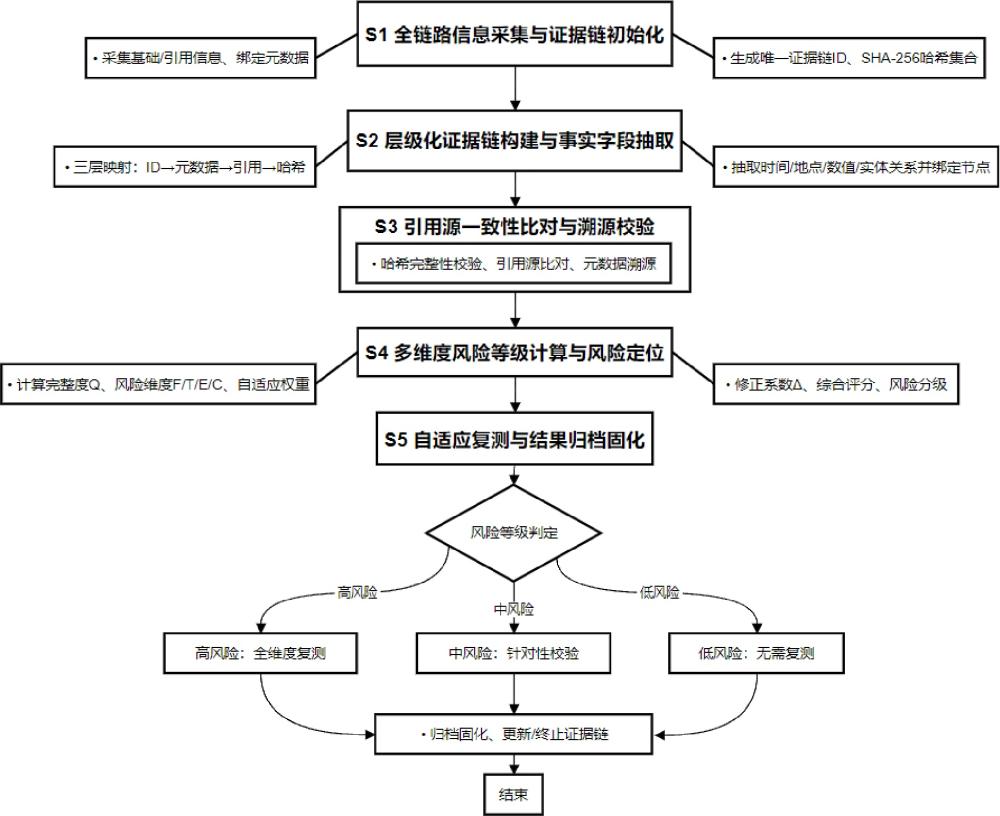
本发明涉及生成式问答可信治理领域,尤其涉及一种生成式问答回答证据链构建、溯源校验与风险识别方法。
背景技术:
1、生成式大模型在问答场景中已实现广泛应用,检索增强生成(rag)技术通过引入外部检索文档,有效缓解了大模型知识滞后、幻觉严重的问题。当前行业内已普遍采用sha-256 哈希算法完成文本、网页快照完整性校验,依托 merkle 树实现批量哈希根存证,借助 nlp 实体识别与关系抽取算法提取文本事实信息,上述均为通用成熟底层技术;现有相关专利在可验证生成、aigc 溯源领域取得一定进展,但大多仅将上述成熟工具进行简单拼接使用,未针对生成式问答场景设计专属联动量化体系,底层技术空白显著,无法满足生成式问答高可信、可追溯、可管控的核心需求。
2、现有专利 cn121301554b(江南大学,授权公告日 2026.05.08)公开了一种基于证据链的可验证大模型检索增强生成系统及方法,通过启发式问题生成、可信答案验证、层级化归因映射及自适应终止评估四大模块,解决了传统 rag 信息整合碎片化、模糊查询回答片面、归因低效及过度依赖检索内容的缺陷,具备答案全面性、可验证与部署轻量化优势。然而,该专利仅聚焦答案与检索文档的关联性验证,缺乏生成式问答全链路元数据绑定机制,未覆盖模型标识、会话轮次、时间戳等关键追溯信息;缺少引用源防篡改校验设计,无页面快照存证、哈希指纹比对等底层防篡改手段;未构建多维度风险量化体系,无法精准定位风险来源与等级;无标准化复测与结果归档机制,风险处理过程与结果不可复现、不可固化。
3、现有专利 cn116910792a(武汉汉王数据技术有限公司,申请公布日 2023.10.20)公开了一种人工智能生成内容处理方法、系统、设备及存储介质,通过模糊哈希算法生成内容散列值,结合非对称加密数字签名技术,嵌入模型版本、发布者等元信息,实现 aigc 内容的鉴定、溯源及完整性验证。但该专利面向通用 aigc 内容治理,未针对生成式问答场景定制化设计,无法适配检索引用 url、引用片段、页面快照等特有信息的校验需求;缺乏问答会话层级的证据链构建逻辑,未关联会话轮次、查询哈希等问答专属元数据;未涉及生成式问答的风险识别与等级计算,无法识别引用失效、事实错误等场景化风险;无闭环复测归档机制,难以支撑生成式问答全生命周期风险管控。
4、综上,现有技术存在四大核心技术缺陷:一是回答内容无法追溯,未绑定生成模型、会话轮次、时间戳等全链路元数据,无法还原生成上下文、定位责任主体;二是引用来源无法校验,依赖单一文本比对,缺乏快照存证、哈希校验等防篡改机制,url 失效、内容篡改时无法识别;三是风险来源无法定位,无多维度风险评估模型,仅简单叠加哈希、实体抽取输出的零散指标,采用固定权重线性计算,单维度极端高危隐患会被其他低风险维度稀释,出现严重漏判,无法量化风险等级、精准定位至具体证据节点;四是复测结果无法固化,缺少标准化复测流程与不可篡改归档机制,风险处理过程与结果易丢失、不可复现。
5、需要着重说明:sha-256 哈希、merkle 树、nlp 实体抽取、rag 检索增强均为行业通用成熟基础技术,仅能独立输出二元匹配结果、文本相似度、事实冲突数量等孤立原始指标,不存在联动评估、极端风险修正、自适应权重分配的逻辑;现有方案仅对上述成熟技术进行简单拼接,未设计一套将分散指标统一运算、自动修正重度风险的专属数学量化模型,无法解决极端风险漏判、评估结果失真等关键痛点,上述缺陷也无法依靠底层成熟工具自身优化消除,最终导致生成式问答内容可信度低、风险管控难,无法满足金融、政务、医疗等高可信场景需求,需要一种全新的生成式问答证据链溯源与风险量化方案。
技术实现思路
1、发明目的:本发明旨在克服现有技术的不足,提供一种生成式问答回答证据链构建、溯源校验与风险识别方法,解决生成式问答中回答内容无法追溯、引用来源无法校验、风险来源无法定位、复测结果无法固化的技术问题,为生成式问答提供底层可信技术支撑。
2、技术方案:为解决上述技术问题,根据本发明的一个方面,更具体的说是一种生成式问答回答证据链构建、溯源校验与风险识别方法,包括以下核心步骤:
3、s1 全链路信息采集与证据链初始化
4、接收用户查询与大模型生成的初始回答,执行多维度信息采集与元数据绑定:基础元数据采集:绑定 model_id(模型唯一标识)、model_version(模型版本)、生成时间戳、session_id(会话编号)、turn_id(会话轮次)、query_hash(查询文本 sha-256 哈希值);多源引用信息采集:提取回答关联的 source_url(检索文档 url)、answer_hash(回答哈希)、核心引用片段、原始页面快照;全局唯一标识生成:联合 model_id、可信时间戳、session_id、turn_id、query_hash 生成 evidence_chain_id(证据链全局唯一 id);哈希指纹计算:统一采用 sha-256 算法对初始回答、引用片段、原始页面快照分别计算哈希值,汇总所有哈希值形成标准化证据链哈希集合,完成证据链初始化。
5、本步骤依托 sha-256 哈希这一成熟底层技术完成指纹采集,仅输出固定哈希数值,无全局可信度量化、风险修正能力,仅作为后续风险计算的基础输入数据。
6、s2 标准化证据链节点数据结构构建与事实字段抽取
7、定义完整证据节点结构化字段,全部字段绑定至独立节点:evidence_chain_id、node_id、parent_node_id、model_id、model_version、session_id、turn_id、query_hash、answer_hash、source_url、snapshot_hash、previous_node_hash、fact_fields、risk_vector、verify_status;三层层级关联映射:第一层关联 evidence_chain_id 与全量溯源元数据;第二层关联元数据与引用 url、引用片段、页面快照;第三层绑定当前节点的前序节点哈希 previous_node_hash,形成链式关联结构;事实字段抽取:采用成熟实体识别与关系抽取 nlp 算法,抽取时间、地点、数值、实体关系四类核心 fact_fields,建立字段索引并绑定至对应 node_id;节点状态标记:通过 verify_status 记录节点校验结果,状态包含未校验、校验通过、篡改风险、引用失效四类。
8、本步骤中实体抽取仅能提取文本事实并统计匹配 / 冲突数量,仅输出原始统计指标,无法自主完成全局风险分级与极端风险修正,仅作为风险计算模块的输入基础。
9、s3 引用源一致性比对与溯源校验
10、依托证据链哈希集合、节点链式哈希关系执行三层校验机制:哈希完整性校验:实时重新计算回答、引用片段、快照哈希值,与哈希集合逐一比对,哈希不一致则标记当前节点存在篡改风险;引用源一致性比对:实时拉取 source_url 对应的最新页面内容,与原始快照进行文本相似度比对,同时校验引用片段是否原生存在于源文档;元数据反向溯源:通过 evidence_chain_id 调取全量节点数据,完整还原模型版本、会话上下文、生成时间,精准定位内容生成主体与检索来源。
11、依靠链式哈希、merkle 树成熟技术实现批量完整性校验;哈希、merkle 树机制仅能识别内容修改、文件缺失、节点顺序错乱,无法阻止文件物理删除、覆盖替换操作,仅在校验环节输出二元异常标记,无风险量化、自动修正能力,可配套可信时间戳、非对称数字签名强化存证能力。
12、s4 多维度风险量化计算与风险分级
13、本发明区别于现有仅复用成熟哈希、实体抽取、rag 工具的技术方案,突破为整套适配生成式问答可信治理场景、具备突变风险自动修正能力的闭环量化计算体系。sha-256快照哈希、实体关系抽取、merkle 树、rag 检索仅作为数据采集与指标提取的底层成熟工具,仅负责输出 t(内容篡改偏差度)、e(事实字段偏差度)、f(引用源失效度)、c(多源冲突度)四类基础量化数值;成熟工具输出的原始指标彼此独立、无联动评估逻辑,仅依靠上述工具无法实现全局风险统一评估、极端高危自动预警。只有将四类原始指标输入本发明的「证据链完整度计算公式、自适应动态权重分配逻辑、突变修正系数 δ、耦合式综合风险risk 计算公式」联动运算,才能生成现有技术简单拼接无法实现的全新可信管控效果,各模块针对性设计思路如下:
14、证据链完整度 q:将元数据、引用、快照、哈希四类存证要素量化加权,量化证据链本身的存证可靠基底,为风险权重自适应调整提供量化依据;仅依靠哈希、实体抽取无法全局量化证据链完整程度;
15、四大风险向量 f/t/e/c:针对生成式问答特有幻觉、引用失效场景定制,区别于通用 aigc 风险指标,精准刻画四类核心可信隐患;
16、自适应动态权重:打破传统固定权重线性加权模式,权重数值随证据链完整度 q 动态调整,证据存证残缺时自动放大对应风险维度权重,评估结果贴合真实业务可信度;
17、突变修正系数 δ:专门解决传统线性加权模型「单维度极端高危被低风险维度稀释、重度风险漏判」行业痛点。当任一风险维度数值超过 0.8 高危阈值,判定存在重度可信隐患,自动追加正向风险修正值(上限 0.15),强制抬高综合风险评分;无极端高危场景时δ=0,不干扰常规风险评估;现有所有哈希、实体抽取组合方案均未设置该修正机制;
18、综合风险 risk 耦合公式:将自适应加权风险值与突变修正系数耦合运算,输出统一区间 [0,1] 标准化风险值,形成无主观偏差的分级依据,直接联动后端差异化复测闭环。
19、1. 证据链完整度 q 计算公式
20、约束条件:;为 0-1 二值标识,要素完整取 1、要素缺失 / 失效取 0;。固定权重分配:。
21、2. 四大标准化风险向量(取值统一区间 [0,1])
22、f(引用源失效度):url 正常无变更时 f=0;页面轻微更新 / 重定向 f=0.3;域名过期 / 页面失效 f=0.7;页面 404 / 访问超时完全不可用 f=1;t(内容篡改偏差度):,sim 为原始快照与实时页面文本相似度;e(事实字段偏差度):;c(多源冲突度):。
23、3. 突变修正系数 δ 计算逻辑
24、触发规则:时,;时,,δ 取值区间固定 [0,0.15],仅正向抬高风险评分,不降低整体风险。
25、4. 综合风险评分总公式
26、约束条件:;权重随证据链完整度 q 自适应动态分配。
27、5. 标准化风险分级标准
28、低风险:综合风险值∈[0,0.3];中风险:综合风险值∈(0.3,0.7];高风险:综合风险值∈(0.7,1]。
29、s5 分级复测与可验证防篡改归档
30、差异化复测策略:高风险:执行全维度复测,重新检索权威文档、交叉比对全部事实字段、完整哈希链校验;中风险:针对性校验,仅核验引用源完整性、快照哈希一致性;低风险:跳过复测流程;
31、归档对象:原始问答文本、页面快照、全量节点字段、风险向量参数、复测过程日志、复测结果、可信时间戳、数字签名;归档存储机制:采用追加式日志或 merkle tree 存储归档文件,归档文件绑定原始 evidence_chain_id;
32、证据链迭代更新:复测合格则更新节点 risk_vector、verify_status;复测不合格则标记证据链失效,终止证据链流转,实现问答全生命周期风险管控。
33、有益效果:
34、标准化全链路溯源架构:设计标准化证据节点数据结构,统一全链路溯源字段,依托哈希链式存证实现问答生成全流程可追溯、责任主体可定位,完整留存会话、模型、时间维度溯源信息,现有简单拼接成熟工具的方案无法实现全维度统一存证。
35、分层可验证防篡改存证体系:采用链式哈希 + merkle tree + 可信时间戳构建校验体系,摒弃 “不可篡改” 绝对化表述,可精准识别内容篡改、文件缺失、节点乱序问题,成熟哈希工具仅能单点校验,无法实现全链路批量节点校验。
36、突变修正系数解决行业高危漏判痛点:仅依靠哈希、实体抽取等成熟工具仅能识别单点隐患,无极端风险放大机制;本发明通过阈值触发的正向 δ 修正逻辑,当页面大面积篡改、全量事实冲突等致命缺陷出现时,自动抬高综合风险评分,精准拦截重度模型幻觉、恶意污染引用源等高危害场景,是现有技术简单拼接无法实现的独有效果。
37、自适应动态权重耦合量化体系:区别于现有固定权重评估方案,依托 sha-256 快照哈希、实体抽取输出的存证与事实指标,通过证据链完整度 q 动态调整各风险维度权重,证据链缺失越严重,对应风险维度权重越高,风险评估结果更贴合真实可信等级。
38、整套量化体系标准化、全流程可复现:所有计算逻辑由固定数学公式定义,无人工主观判定空间;哈希、实体抽取等成熟工具仅提供原始输入数据,唯有搭配本发明专属耦合计算公式,才能输出统一、合规、可审计的标准化风险分级结果,满足金融、政务等高可信场景监管溯源要求。
39、成熟底层工具与量化模型形成技术协同增益:merkle 树、哈希负责存证防篡改,实体抽取负责事实冲突识别,rag 负责多源引用采集,四类成熟技术输出的指标统一汇入风险计算公式,最终实现单点隐患识别→全局风险量化→自动分级复测的完整可信管控链路,产生任意单一成熟技术无法独立实现的全链路风险治理能力。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com