
一种C/C++漏洞基准构建与多智能体评测方法及系统与流程
本发明涉及计算机软件安全与人工智能评测交叉,具体为一种c/c++漏洞基准构建与多智能体评测方法及系统。
背景技术:
1、c/c++ 语言广泛应用于操作系统、浏览器、媒体处理、移动平台以及机器学习框架等领域,其内存管理、指针运算与复杂构建环境的特性,使得软件安全漏洞具有较强的上下文依赖性。随着大语言模型被逐步应用于代码审查与漏洞检测工作,行业内需要能够反映真实漏洞特征、支持精细粒度定位并提供充分判定上下文的基准数据集,以实现对模型漏洞检测能力的有效评估;
2、现有技术中公开号为 cn122365516a 的专利文献提供:一种多粒度漏洞评估数据集构建方法、装置及设备,包括采集多源漏洞数据并执行清洗去重处理,基于抽象语法树分析生成多粒度补丁对样本,标注多维元数据后构建正负样本数据集,用于漏洞检测模型的训练与评估;
3、现有技术中公开号为 cn121659331a 的专利文献提供:一种基于大模型与多智能体的自动化代码审计方法,包括搭建多智能体协同架构执行代码漏洞分析,通过多智能体并行输出审计子报告,经汇总与冲突消解后生成最终代码漏洞审计结果。
4、现有技术中的c/c++漏洞基准构建与多智能体评测方法主要存在下列问题:现有主流 c/c++ 漏洞检测基准多采用函数级二分类标注体系,仅能对 “函数是否存在漏洞”进行判定;部分方案如公开号 cn122365516a 的专利虽实现了多粒度样本构建,但仍未针对 c/c++ 语言完成完整语义语句的成对标注,仅能提供零散的行级代码片段,而 c/c++语句常跨越多行书写,单行片段缺失完整语法结构与数据流语义,无法对应完整的致因逻辑,最终导致评测无法区分模型是真正识别了漏洞根因,还是依赖变量名、代码长度等表面伪特征完成分类,评测结果无法反映模型的真实漏洞分析能力;
5、同时,c/c++ 语言的内存操作、指针运算等漏洞成因具有强上下文依赖性,漏洞是否成立需结合函数参数约束、外部函数行为、类型定义、全局符号状态及执行环境条件等多维度信息共同判定,但现有漏洞数据集及相关构建专利均仅保留孤立的漏洞函数代码,未同步提供函数参数、外部函数、类型声明、全局符号和执行环境五类结构化必要判定信息,使得模型无需理解完整代码上下文即可完成分类任务,评测条件与真实代码审查场景存在较大差异,评测结果无法体现模型在实际工程场景中的检测能力;
6、其次,一方面,现有公开漏洞样本普遍存在函数重复、纠缠式无关修改、标注不一致等问题,易引发训练集与测试集的数据泄漏,导致模型性能虚高与泛化能力误判;另一方面,现有评测方案多采用单模型一次性推理模式,部分多智能体审计方案如公开号cn121659331a 的专利,仅聚焦漏洞排查过程本身,未配套细粒度的双层评测机制,且未与高质量漏洞基准形成一体化的评测链路,无法暴露长函数漏检、特定缺陷类型过度告警等真实能力局限,难以客观衡量模型的实际应用价值。
技术实现思路
1、本部分的目的在于概述本发明的实施方式的一些方面以及简要介绍一 些较佳实施方式。在本部分以及本技术的说明书摘要和发明名称中可能会做些简化或省略以避免使本部分、说明书摘要和发明名称的目的模糊,而这种简化或省略不能用于限制本发明的范围。
2、1.要解决的技术问题:
3、为了解决上述中存在的无法验证漏洞根因识别能力、必要判定上下文缺失和数据质量管控不足且评测方式单一的问题,提出了本发明。
4、因此,本发明的目的是提供一种c/c++漏洞基准构建与多智能体评测方法及系统,实现语句级漏洞成对标注,可验证模型对漏洞根因的真实识别能力,弥补粗粒度标签的评测局限,同时,补充五类结构化必要上下文,还原真实漏洞判定的信息条件,缩小评测与实际应用场景的差异,其次,组合式数据清洗结合多智能体双层评测,保障数据质量与评测可靠性,客观反映模型真实检测能力。
5、2.技术方案:
6、为解决上述技术问题,根据本发明的一个方面,本发明提供了如下技术方案:
7、一种c/c++漏洞基准构建与多智能体评测方法,其包括基准构建阶段与多智能体评测阶段;
8、所述基准构建阶段包括:
9、s1 采集携带补丁信息的c/c++语言相关的cve漏洞记录;
10、s2 根据漏洞记录对应的修复提交,提取补丁前的漏洞版本函数与补丁后的修复版本函数;
11、s3 通过语言过滤、提交筛选、函数变更校验、纠缠变更剔除、函数格式归一化哈希去重的组合规则完成数据过滤去重;
12、s4 基于语法解析器将变更行恢复为完整源代码语句,分别生成漏洞语句集合与修复语句集合;
13、s5 抽取函数参数、外部函数、类型声明、全局符号和执行环境五类上下文信息并关联至对应漏洞样本,形成结构化漏洞基准;所述多智能体评测阶段包括:
14、s6 通过规范化智能体对输入函数进行语法解析与规范化处理;
15、s7 通过规划智能体生成函数摘要与潜在漏洞检查清单;
16、s8 通过上下文智能体分轮次请求补充外部符号定义,直至上下文充分或达到迭代上限;
17、s9 通过检测智能体综合全部信息完成漏洞判定,输出漏洞语句定位结果与根因解释;
18、s10 通过验证智能体复核检测结果,判定不一致时触发检测智能体重检,直至结果一致或达到重检上限;
19、s11 通过函数级与语句级双层评测机制输出评测结果,语句级评测以漏洞语句定位与根因解释的正确性作为真阳性判定依据。
20、作为本发明的一种c/c++漏洞基准构建与多智能体评测方法的一种优选方案,其中,步骤s2具体为:调用github rest api获取包含提交标识、提交说明及变更文件的提交数据,定位各变更文件中新增行与删除行所属的函数,将删除行对应的补丁前函数作为漏洞函数,将新增行对应的补丁后函数作为修复后函数。
21、漏洞语句定位与根因解释的正确性作为真阳性判定依据。
22、作为本发明的一种c/c++漏洞基准构建与多智能体评测方法的一种优选方案,其中,步骤s3中,所述函数格式归一化哈希去重规则为:去除函数首尾空白、换行符与制表符后计算md5摘要,基于摘要一致性完成去重判定。
23、作为本发明的一种c/c++漏洞基准构建与多智能体评测方法的一种优选方案,其中,步骤s5以cwe标识、cve描述、提交说明、完整函数体及补丁变更信息为输入,通过大语言模型执行上下文抽取,生成所述五类上下文信息。
24、作为本发明的一种c/c++漏洞基准构建与多智能体评测方法的一种优选方案,其中,步骤s8中上下文智能体每轮请求的未重复符号数量不超过六个,迭代请求轮次不超过三次;步骤s10中重检次数上限为三次。
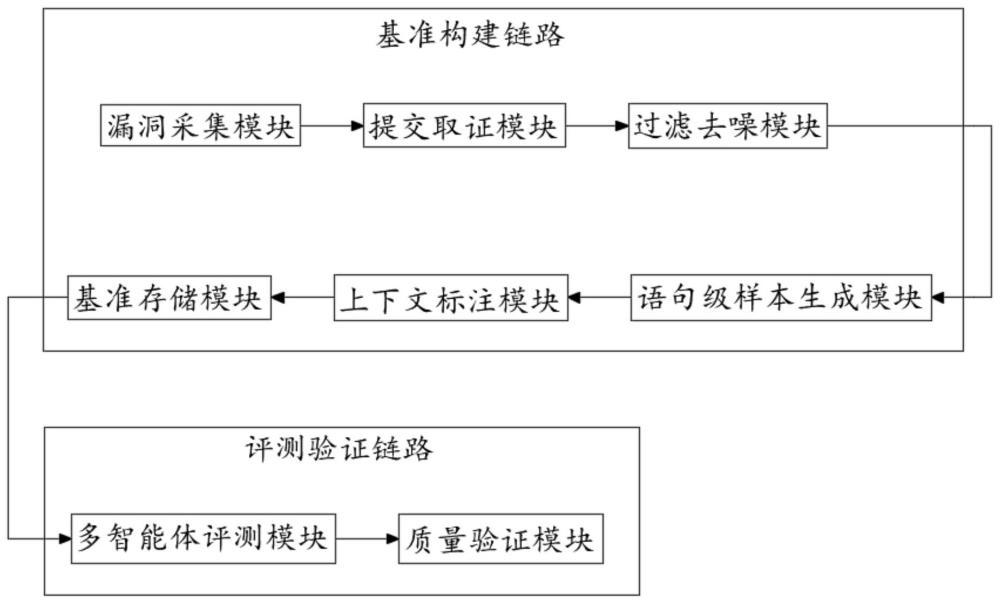
25、一种c/c++漏洞基准构建与多智能体评测系统,其包括漏洞采集模块、提交取证模块、过滤去噪模块、语句级样本生成模块、上下文标注模块、基准存储模块、多智能体评测模块及质量验证模块;
26、所述漏洞采集模块、提交取证模块、过滤去噪模块、语句级样本生成模块、上下文标注模块和基准存储模块按数据处理顺序依次数据耦合,形成漏洞基准构建链路;
27、所述多智能体评测模块与所述基准存储模块数据耦合,用于读取基准样本数据;
28、所述提交取证模块用于根据修复提交中的变更行定位所属函数,提取补丁前的漏洞版本函数与补丁后的修复版本函数;
29、所述过滤去噪模块用于执行纠缠变更过滤与函数格式归一化哈希去重;
30、所述语句级样本生成模块用于基于语法解析器将变更行恢复为完整源代码语句,形成漏洞语句集合与修复语句集合;
31、所述上下文标注模块用于抽取五类上下文信息并关联至漏洞样本;
32、所述多智能体评测模块配置有规范化智能体、规划智能体、上下文智能体、检测智能体与验证智能体;
33、所述上下文智能体用于分轮次请求外部符号定义;
34、所述验证智能体用于复核检测结果,不一致时触发重检并设置重检上限;
35、所述质量验证模块配置有函数级与语句级双层评测机制,语句级评测以漏洞语句定位与根因解释的正确性作为真阳性判定依据。
36、作为本发明的一种c/c++漏洞基准构建与多智能体评测系统的一种优选方案,其中,所述语句级样本生成模块采用tree-sitter解析器完成语句边界恢复;
37、所述上下文标注模块以cwe标识、cve描述、提交说明、函数体及补丁信息为输入,通过大语言模型生成五类上下文信息。
38、作为本发明的一种c/c++漏洞基准构建与多智能体评测系统的一种优选方案,其中,所述规划智能体输出包含函数摘要与潜在漏洞检查清单的分析结果;
39、所述上下文智能体针对检查清单对应的外部符号分轮次请求定义,每轮请求未重复符号数量不超过六个,且迭代轮次不超过三次。
40、作为本发明的一种c/c++漏洞基准构建与多智能体评测系统的一种优选方案,其中,所述基准存储模块的每个样本记录存储有cve标识、cwe标识、项目名称、提交标识、文件路径、漏洞函数、修复函数、漏洞语句集合、修复语句集合及五类上下文信息。
41、作为本发明的一种c/c++漏洞基准构建与多智能体评测系统的一种优选方案,其中,所述系统各模块由处理器执行存储器中的程序指令实现,部署于同一服务器或通过任务队列、数据库、对象存储架构分布式部署;
42、且所述多智能体评测模块配置有防御性安全约束,限定输出为结构化json格式,且禁止生成漏洞利用步骤与虚构代码符号。
43、3.有益效果:
44、与现有技术相比,本发明具有的有益效果是:
45、该种c/c++漏洞基准构建与多智能体评测方法及系统,对应解决标签粒度粗糙的缺陷,本方案基于语法解析器对补丁变更行进行完整语句边界恢复,将跨行书写的代码片段重构为具备完整语义的独立语句单元,同时形成漏洞语句集合与修复语句集合的成对标注,弥补了 cn122365516a 等现有方案多粒度标注仍未覆盖完整语义语句的不足,将漏洞标签从函数级二分类下沉至可解释的语句级根因定位维度,使评测能够区分模型对漏洞根因的真实识别能力与基于表面特征的分类能力,为细粒度漏洞检测评测提供了可行的标注基础;
46、该种c/c++漏洞基准构建与多智能体评测方法及系统,对应解决上下文缺失的缺陷,本方案围绕漏洞判定的实际信息需求,为每个漏洞样本抽取并关联函数参数、外部函数、类型声明、全局符号和执行环境五类结构化上下文信息,补全了跨函数、跨类型、跨环境层面的漏洞判定依据,填补了现有数据集与构建专利未系统性提供必要判定上下文的空白,还原了真实代码审查场景下的信息输入条件,避免因上下文缺失导致的评测失真,使评测结果更贴近模型在实际工程场景中的表现;
47、该种c/c++漏洞基准构建与多智能体评测方法及系统,对应解决数据质量与评测方式单一的缺陷,本方案通过语言过滤、提交筛选、函数变更校验、纠缠变更剔除、函数格式归一化哈希去重的组合规则完成数据清洗,保障基准数据的纯净性,避免数据泄漏引发的性能虚高;同时采用五阶段多智能体协作流水线完成漏洞检测,搭配函数级与语句级双层评测机制,既弥补了 cn121659331a 等多智能体方案缺乏标准化评测基准与细粒度评价标准的不足,也可客观暴露模型在长函数、特定缺陷类型下的能力局限,提升评测结果的可信度与参考价值。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com